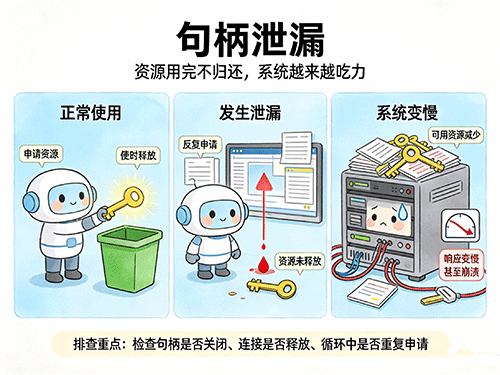
资源泄漏的根源是程序未正确释放已分配的资源,导致资源被持续占用而无法再利用。
一、通用检测
资源泄漏的根源是程序未正确释放已分配的资源,导致资源被持续占用而无法再利用。三类泄漏的表征和排查手段各有侧重。
1. 快照对比法
在关键操作前后分别采集资源快照,对比增量。FD泄漏检测的典型实现是:运行被测函数前后各取一次文件描述符快照,after中有而before中没有的即为泄漏。内存、连接同理。
2. 监控趋势和阈值告警
持续采集资源使用量,观察增长斜率。FD泄漏的早期信号是进程句柄数持续上升而非收敛。连接泄漏的特征是连接数随时间持续上涨,无业务高峰也上涨,重启应用后不久又上涨。
3. 压力测试暴露渐进泄漏
长时间、高并发场景下运行,泄漏累积到可观测的规模。CI中可集成周期性的压力测试和长时间运行测试,持续监控资源曲线。
二、内存泄漏的检测和定位
1. 现象识别
进程RSS持续增长、GC后堆内存无法回落、最终触发OOM,是最直接的信号。Java场景下可先用以下命令观察Full GC后老年代使用量是否持续偏高:
bash
jstat -gc <PID> 1000
2. Java 堆转储和支配树分析
定位 Java 内存泄漏的标准路径如下。
第一步:抓取堆转储。
可在 OOM 时通过 -XX:+HeapDumpOnOutOfMemoryError 自动转储,或手动执行:
bash
jmap -dump:live,format=b,file=heap.hprof <PID>
第二步:用 Eclipse MAT 分析。
打开堆转储后,优先查看 Leak Suspects Report,再通过 Dominator Tree 找出 retain heap 最大的对象,沿最短引用链追溯到 GC Root,即可定位谁在持有本应被回收的对象。Histogram 视图适合快速查看某个类的实例数是否异常膨胀。
第三步:对照常见泄漏模式。
Java 中高频泄漏场景包括:
静态集合持续 add 不清理
ThreadLocal 使用后未 remove
监听器或回调注册后未注销
动态代理导致类加载器无法回收
3. 原生代码内存泄漏
C/C++ 原生代码的泄漏检测工具主要分两类。
Valgrind
无需重新编译,直接对二进制运行,通过虚拟 CPU 拦截内存访问指令,维护合法性位图,跟踪每个字节的分配和初始化状态。它能报告泄漏总大小及分配位置,但性能开销高达 20 到 50 倍,适合离线深度分析。
AddressSanitizer 和 LeakSanitizer
ASan 是编译期插桩方案,在编译时插入检测代码,运行时通过 shadow memory 跟踪内存字节状态,性能开销仅 2 到 5 倍。配合 LeakSanitizer 可在程序退出时输出泄漏报告。编译时添加:
bash
-fsanitize=address
即可同时启用两者。ASan 更适合在开发阶段和 CI 中高频运行,Valgrind 则在 ASan 无法覆盖的场景中做补充。
三、连接泄漏的检测和定位
1. 数据库侧确认泄漏存在
从数据库端入手,确认连接数是否异常。
MySQL 可执行:
sql
SHOW STATUS LIKE 'Threads_connected';
PostgreSQL 则查询:
sql
SELECT * FROM pg_stat_activity;
判断:Threads_connected 远大于 Threads_running,且差值持续扩大,基本可确认连接泄漏。
进一步用 information_schema.processlist 按 host、user 聚合,可定位到是哪个应用服务器在泄漏。
2. 连接池监控定位具体代码
现代连接池提供了内建的泄漏检测能力。以Druid为例,开启以下配置后,连接超时未归还时会被强制回收,并打印打开该连接的堆栈:
yaml
removeAbandoned: true
removeAbandonedTimeout: 1800
logAbandoned: true
回收时日志中会输出 abandon connection, owner thread: ... 以及完整的 open stackTrace,直接指向未关闭连接的代码位置。
HikariCP 对应的是 leakDetectionThreshold 参数。活跃连接数、空闲连接数、等待线程数等指标可通过 JMX 或 APM 采集。
3. 代码侧排查
连接泄漏通常集中在:
忘记 close,包括 Connection、Statement、ResultSet 任一层级
异常分支未释放
事务未提交或回滚
线程池和数据库连接混用不当
排查时应特别关注异常路径和异步任务中的资源释放逻辑。
四、句柄泄漏的检测和定位
1. Linux下FD泄漏排查
快速判断进程FD总量趋势:
bash
watch -n 2 "ls /proc/$(pgrep myapp)/fd | wc -l"
若计数持续增长不收敛,即可确认存在 FD 泄漏。
分类定位泄漏的 FD 类型:
bash
lsof -p $(pgrep myapp) | awk '{print $5}' | sort | uniq -c | sort -rn
这会按 FD 类型统计数量,例如 SOCK、REG、PIPE 等,快速识别是 socket 泄漏还是文件泄漏。
排查 CLOSE_WAIT 状态:
对端已发 FIN,但本端未 close,socket 会卡在 CLOSE_WAIT 状态,FD 永远不被回收。
bash
lsof -p <PID> | grep -c 'CLOSE_WAIT'
大量 CLOSE_WAIT 通常指向长连接断开后未调用 close 的代码缺陷,例如 WebSocket、HTTP keep-alive。
开发阶段预防:
FindBugs 可静态检测“创建了 IO 流但未在所有异常路径上关闭”的代码模式,在编译期就发现潜在的 FD 泄漏点。
2. Windows 句柄泄漏排查
使用 Sysinternals 的 Process Explorer,在进程属性中添加 Handle Count、USER Objects、GDI Objects、Private Bytes 列,观察句柄数是否随操作持续增长。
对于句柄泄漏的精准定位,WinDbg 配合 htrace 可记录每个句柄的 OPEN 和 CLOSE 调用堆栈。通过对比 OPEN 而未出现对应 CLOSE 的句柄,直接定位到创建该句柄的代码位置。
3. 测试阶段自动化检测
在单元测试或集成测试中,可在测试函数执行前后自动对比 FD 数量,将泄漏检测融入测试流程。
Go 语言的 fdleak 包即采用此模式:对被测函数执行前后各取一次 FD 快照,after 中存在而 before 中不存在的 FD 即为泄漏。
五、工具工程化集成
按泄漏类型和阶段选择工具。
内存泄漏,Java 运行态可用jmap加MAT,定位能力是引用链追溯GC Root。
内存泄漏,C/C++ 开发或 CI 阶段可用 ASan 加 LSan,定位能力是分配点源码行号。
内存泄漏,C/C++ 离线深度分析可用 Valgrind,定位能力是泄漏大小和分配调用栈。
连接泄漏,运行态可用 Druid 或 HikariCP 监控,定位能力是未关闭连接的堆栈。
句柄泄漏,Linux 运行态可用 lsof 加 ss 脚本,定位能力是 FD 类型和 CLOSE_WAIT 数量。
句柄泄漏,Windows 运行态可用 Process Explorer 或 WinDbg htrace,定位能力是句柄 OPEN 调用栈。
通用检测,CI 流水线可用快照对比加压力测试,定位能力是回归检测。
建议:
在CI中加入ASan和LSan编译选项,使内存泄漏在单测阶段即被拦截
集成测试中引入 FD 快照对比
生产环境部署连接池监控和 FD 数趋势告警
借鉴LeakDetector这类框架的思路:60 秒遍历一次进程,FD 总数超过阈值时抓取详细句柄信息并同步上报
 400-607-0568