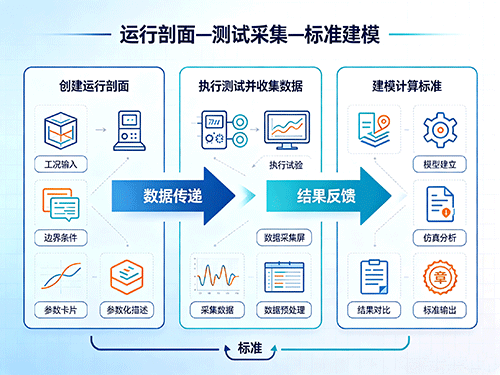
软件可靠性测试是通过模拟真实用户的使用方式,统计方面量化软件的失效行为从而计算出MTBF、失效率等标准。流程为:创建运行剖面 - 执行测试并收集数据 - 建模计算标准。
标准定义和计算公式
在开始测试前,需要确定几个标准的定义和换算关系:
MTBF (Mean Time Between Failures):平均故障间隔时间,指两次相邻失效之间的平均运行时间。基本公式为:
MTBF = 总运行时间 / 故障次数
如,如果软件累计运行72小时,期间发生3次故障,则MTBF=72/3=24小时。
失效率 (λ):单位时间内发生失效的概率,和MTBF互为倒数关系:
λ = 1 / MTBF
在上例中失效率 λ = 1/24 ≈ 0.042 次/小时。
MTTR (Mean Time To Repair):平均修复时间,指从故障发生到修复完成所需的平均时间。和MTBF共同决定了系统的可用性 (Availability):
可用性 = MTTF / (MTTF + MTTR) ≈ MTBF / (MTBF + MTTR) (当修复时间远小于运行时间时)
怎样测量的实操流程
要获得有意义的MTBF和失效率数据,需要按照严谨的测试设计。
第一步:创建运行剖面 (Operational Profile)
这是可靠性测试区别于普通功能测试的重点。运行剖面是对软件在实际使用中各种操作类型及其发生概率的统计描述。
创建方法:可以通过分析生产环境的用户操作日志,或采用专家考虑法(如Delphi方法)来估计各类功能的使用频率。
作用:保证测试用例的分布和真实使用场景一致,使得高频、高风险的操作获得更多测试资源,从而使计算出的可靠性标准更加有代表性。
第二步:设计并执行测试
测试环境:硬件配置应和生产环境保持1:1或按比例缩减,网络条件需模拟真实用户的地理分布。
测试执行:
时长要求:为了获得统计上可信的结果,不断运行时间建议至少达到目的MTBF值的5倍。
方法:采用“浴缸曲线”方法,在测试初期进行密集监控,系统稳定后转为定期检查。
记录:必须精确记录每一次故障发生的时间戳和系统恢复时间。
第三步:收集数据和计算
数据:需要收集的数据包括每次失效的精确时间、失效类型、操作结果,以及软件运行时间(可以是CPU执行时间或时钟时间)。
计算示例:假设测试总运行时间为72小时,期间发生3次故障,每次修复耗时分别为0.2、0.5、1.0小时。
有效运行时间 = 72 - (0.2 + 0.5 + 1.0) = 70.3 小时
MTBF = 70.3 / 3 ≈ 23.43 小时
MTTR = (0.2 + 0.5 + 1.0) / 3 = 0.57 小时
可靠性增长测试和证实测试
除了直接测量,可靠性测试还常用于两个特定目的:
可靠性增长测试 (Reliability Growth Testing):这是一个“测试-分析-修复-再测试”的循环过程。通过不断发现并修复缺陷,推动软件可靠性逐步提升。此过程常借助Goel-Okumoto、Jelinski-Moranda等可靠性增长模型来预测未来的失效趋势和剩余缺陷数。
可靠性证实测试 (Reliability Demonstration Testing):目的是在给定的统计置信度下,证实软件的可靠性是不是达到了设定目的(如MTBF ≥ 1000小时)。常用的方法包括序贯测试和根据贝叶斯的证实方法。
测试方法和局限性
故障注入 (Fault Injection):一种主动的测试技术,通过人为地将故障(如网络延迟、内存错误)注入系统,来考虑其容错和恢复能力,可作为传统测试的补充。
局限性:对于可靠性要求很高(如失效率10⁻⁹)的软件,仅靠统计测试所需的时间将非常漫长,此时必须结合形式化证实等数学方法来证明其可靠性。
参考标准和工具
在实际项目中,可参考以下国内标准来规范测试过程:
GB/T 29832.3-2013《系统和软件可靠性 第3部分:测试方法》。
GB/T 25000.51-2016《系统和软件工程 系统和软件质量要求和评价》中关于可靠性的要求。
常用的数据收集和分析工具包括 Prometheus + Grafana(监控标准)、ELK/EFK(日志分析)以及专业的可靠性分析工具如 msrat、STRAIT 和 C-SFRAT 等。
软件可靠性标准的测量是一个数据驱动的过程。是通过运行剖面来模拟真实场景并严谨地收集失效数据,借助统计模型将原始数据转化为MTBF、失效率等可量化的工程标准。
 400-607-0568