测试动态 / 测试知识 / 大模型应用测试:AI产品怎么评、怎么测?
大模型应用测试:AI产品怎么评、怎么测?
2026-10-10 作者:cwb 浏览次数:3

大模型应用测试不能只刷公开榜单也不能只测模型本身。要测的是模型、提示词、检索、工具 、工作流 、产品交互组成的整个系统。是把主观体验变成可复现、可追踪、可回归的标准,再结合人工判断、自动测试和在线实验不断迭代。


一、分层:

模型层:基础语言能力、推理、知识、指令按照、多语言、多模态。

应用层:RAG问答、Agent任务、写作、代码、客服、搜索、工作流自动化。

产品层:交互体验、延迟、成本、稳定性、可控性、可解释性。

业务层:任务完成率、用户满意度、留存、转化、客服解决率、ROI。


二、评哪些方面

效果:准确性、相关性、完整性、忠实度、幻觉率、格式合规、引用正确率。

安全:毒性、偏见、隐私泄露、版权、越狱、提示注入、工具滥用。

性能:首token延迟、端到端延迟、P95/P99、吞吐、并发、超时降级。

成本:token 消耗、检索成本、工具调用成本、缓存命中率。

体验:多轮一致性、意图理解、人格稳定、可打断、可纠正、可追溯。

业务:任务完成率、采纳率、满意度、留存、转化、人工替代率。

三、怎么测:

先定场景和标准。确定用户是谁、任务是什么、什么算成功、什么算失败。比如客服问答,成功可以是正确回答且无需转人工。

创建评测集。来源包括真实日志、专家编写、合成数据、边界样本、对抗样本。要有golden set,并不断更新。评测集要包括高频、长尾、异常、敏感场景。

自动测试。规则断言适合格式、字段、引用、工具调用;传统标准如准确率、F1、EM 适合分类和抽取;生成任务可用 BERTScore 等,但要谨慎和人类判断不一定一致。

人工测试。让标注员或领域专家按量表打分或做成对比较。看事实性、有用性、安全性、语气、完整性。要统一标准,做标注一致性检查。

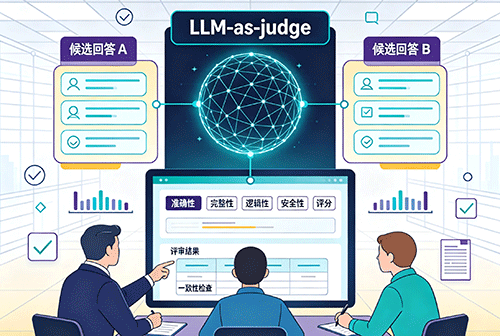
LLM-as-judge。用大模型当裁判,效率高,但要校准。注意位置偏见、冗长偏见、自我偏好。最好和人工评分做一致性测试,并固定judge版本。

在线测试。A/B 测试、灰度发布、影子方式、多臂老虎机。看真实用户行为,不只看点击,还要看任务完成、追问率、转人工率、负反馈。

安全测试。主动尝试越狱、提示词注入、数据泄露、工具越权、有害内容生成。安全测试要不断做,不能只上线前跑一次。

性能和成本测试。压测并发,观察延迟、错误率、限流、降级。统计每次请求的token、检索、工具调用成本。

可观测和回归。记录prompt版本、模型版本、检索文档、工具调用链、评分结果。每次变更都跑回归集,防止修一个坏三个。


四、典型场景怎么评

RAG问答:检索召回率、精确率、上下文相关性、答案忠实度、答案相关性、引用正确率、拒答准确率。

Agent:任务完成率、工具选择正确率、参数正确率、步骤效率、错误恢复能力、权限边界遵守。

对话机器人:多轮一致性、意图识别、人格稳定、安全拒答、打断恢复、情绪处理。

代码助手:编译通过率、测试通过率、漏洞率、可维护性、是不是符合项目规范。

写作助手:事实准确性、风格一致、结构完整、敏感内容、重复率、版权风险。


五、常见问题

只看公开榜单,忽略真实场景。

评测集污染,模型见过答案。

标准和业务脱节,分数高但用户不用。

只测高频,忽略长尾和对抗样本。

一次评测就上线,没有不断回归。

没有版本管理,出问题无法定位。

人工标注标准不一,结果不可比。

过度依赖 LLM judge,缺少人工校准。


从主要的场景开始,先建100到500条高质量评测集。自动考虑做回归,人工考虑做校准,在线实验做证实。安全、性能、成本同步纳入。每次模型、提示词、检索、工具、参数变更,都跑同一套评测并记录版本。上线后不断监控真实日志,定期补充bad case,形成评测-上线-监控-迭代的流程。大模型应用测试等于场景定义、评测集、标准体系、人工和自动结合、在线实验、安全红队、不断回归。不要只评模型,要评整个产品系统。
文章标签: 应用测试 第三方应用测试 软件测试
热门标签 换一换
第三方软件国产化测试 第三方信创测试 CNAS软件测评报告 CMA软件测评报告 首版次软件认定 软件结题验收 软件测试报告书 软件质量检测 数据库测试 H5应用测试 软件质检机构 第三方质检机构 第三方权威质检机构 信创测评机构 信息技术应用创新测评机构 信创测试 软件信创测试 软件系统第三方测试 软件系统测试 软件测试标准 工业软件测试 软件应用性能测试 应用性能测试 可用性测试 软件可用性测试 软件可靠性测试 可靠性测试 系统应用测试 软件系统应用测试 软件应用测试 软件负载测试 API自动化测试 软件结题测试 软件结题测试报告 软件登记测试 软件登记测试报告 软件测试中心 第三方软件测试中心 应用测试 第三方应用测试 软件测试需求 软件检测报告定制 软件测试外包公司 第三方软件检测报告厂家 CMA资质 软件产品登记测试 软件产品登记 软件登记 CNAS资质 cma检测范围 cma检测报告 软件评审 软件项目评审 软件项目测试报告书 软件项目验收 软件质量测试报告书 软件项目验收测试 软件验收测试 软件测试机构 软件检验 软件检验检测 WEB应用测试 API接口测试 接口性能测试 第三方系统测试 第三方网站系统测试 数据库系统检测 第三方数据库检测 第三方数据库系统检测 第三方软件评估 课题认证 第三方课题认证 小程序测试 app测试 区块链业务逻辑 智能合约代码安全 区块链 区块链智能合约 软件数据库测试 第三方数据库测试 第三方软件数据库测试 软件第三方测试 软件第三方测试方案 软件测试报告内容 网站测试报告 网站测试总结报告 信息系统测试报告 信息系统评估报告 信息系统测评 语言模型安全 语言模型测试 软件报告书 软件测评报告书 第三方软件测评报告 检测报告厂家 软件检测报告厂家 第三方网站检测 第三方网站测评 第三方网站测试 检测报告 软件检测流程 软件检测报告 第三方软件检测 第三方软件检测机构 第三方检测机构 软件产品确认测试 软件功能性测试 功能性测试 软件崩溃 稳定性测试 API测试 API安全测试 网站测试测评 敏感数据泄露测试 敏感数据泄露 敏感数据泄露测试防护 课题软件交付 科研经费申请 软件网站系统竞赛 竞赛CMA资质补办通道 中学生软件网站系统CMA资质 大学生软件网站系统CMA资质 科研软件课题cma检测报告 科研软件课题cma检测 国家级科研软件CMA检测 科研软件课题 国家级科研软件 web测评 网站测试 网站测评 第三方软件验收公司 第三方软件验收 软件测试选题 软件测试课题是什么 软件测试课题研究报告 软件科研项目测评报告 软件科研项目测评内容 软件科研项目测评 长沙第三方软件测评中心 长沙第三方软件测评公司 长沙第三方软件测评机构 软件科研结项强制清单 软件课题验收 软件申报课题 数据脱敏 数据脱敏传输规范 远程测试实操指南 远程测试 易用性专业测试 软件易用性 政府企业软件采购验收 OA系统CMA软件测评 ERP系统CMA软件测评 CMA检测报告的法律价值 代码原创性 软件著作登记 软件著作权登记 教育APP备案 教育APP 信息化软件项目测评 信息化软件项目 校园软件项目验收标准 智慧软件项目 智慧校园软件项目 CSRF漏洞自动化测试 漏洞自动化测试 CSRF漏洞 反序列化漏洞测试 反序列化漏洞原理 反序列化漏洞 命令执行 命令注入 漏洞检测 文件上传漏洞 身份验证 出具CMA测试报告 cma资质认证 软件验收流程 软件招标文件 软件开发招标 卓码软件测评 WEB安全测试 漏洞挖掘 身份验证漏洞 测评网站并发压力 测评门户网站 Web软件测评 XSS跨站脚本 XSS跨站 C/S软件测评 B/S软件测评 渗透测试 网站安全 网络安全 WEB安全 并发压力测试 常见系统验收单 CRM系统验收 ERP系统验收 OA系统验收 软件项目招投 软件项目 软件投标 软件招标 软件验收 App兼容性测试 CNAS软件检测 CNAS软件检测资质 软件检测 软件检测排名 软件检测机构排名 Web安全测试 Web安全 Web兼容性测试 兼容性测试 web测试 黑盒测试 白盒测试 负载测试 软件易用性测试 软件测试用例 软件性能测试 科技项目验收测试 首版次软件 软件鉴定测试 软件渗透测试 软件安全测试 第三方软件测试报告 软件第三方测试报告 第三方软件测评机构 湖南软件测评公司 软件测评中心 软件第三方测试机构 软件安全测试报告 第三方软件测试公司 第三方软件测试机构 CMA软件测试 CNAS软件测试 第三方软件测试 移动app测试 软件确认测试 软件测评 第三方软件测评 软件测试公司 软件测试报告 跨浏览器测试 软件更新 行业资讯 软件测评机构 大数据测试 测试环境 网站优化 功能测试 APP测试 软件兼容测试 安全测评 第三方测试 测试工具 软件测试 验收测试 系统测试 测试外包 压力测试 测试平台 bug管理 性能测试 测试报告 测试框架 CNAS认可 CMA认证 自动化测试
专业测试,找专业团队,请联系我们!
咨询软件测试 400-607-0568